Mein Blog, ⌘+F und der Podcast ⌘+P laufen jetzt mit Sanity statt mit Hygraph. Was den Wechsel ausgelöst hat, wofür ich Hygraph weiterhin schätze, worin Sanity nicht besser ist und welche Checkliste ich heute für die Wahl eines CMS nutze.
Es gibt Migrationen, die man immer wieder aufschiebt, weil alles funktioniert. Meine Website lief. Die Artikel erschienen in mehreren Sprachen, der Podcast ⌘+P hatte seine RSS-Feeds, ⌘+F sein Zuhause. Hygraph erledigte seinen Job.
Und trotzdem ist es jetzt so weit: clementsauvage.me, cmdf.io und der Podcast ⌘+P laufen jetzt produktiv auf Sanity. Ein Projekt, ein Inhaltsmodell, sieben Sprachversionen.
Dieser Artikel ist kein „Hygraph ist schlecht, Sanity ist großartig“. Hygraph hat mir gute Dienste geleistet und ist für manche Anforderungen weiterhin eine ausgezeichnete Wahl. Es geht um veränderte Bedürfnisse, zwei sehr konkrete Auslöser — Kosten und KI — und die grundsätzliche Frage, wie man 2026 als Unternehmer ein SaaS-Werkzeug auswählt und auch wieder verlässt.
Ausgangspunkt: ein Stack, der funktionierte
So sah mein Stack vorher aus:
- Hygraph als Headless-CMS mit nativer GraphQL-API
- Next.js 16 (App Router, Turbopack), Tailwind v4
- Apollo Client für die GraphQL-API
- next-intl für sieben Sprachen
- Clever Cloud Cellar (S3) hinter Cloudflare für einen Teil der Dateien, Mux für Video
Nichts Exotisches. Ein moderner, sauberer Stack, den ich vor wenigen Monaten noch Kunden empfohlen habe.
Das Problem war kein Bug. Es war die Entwicklung: mehr Sprachen, mehr Inhalte, mehr Websites und eine Arbeitsweise, die sich zunehmend auf KI-Agenten stützt. Bei jedem Schritt kostete mich Hygraph ein bisschen mehr — Geld oder Reibung.
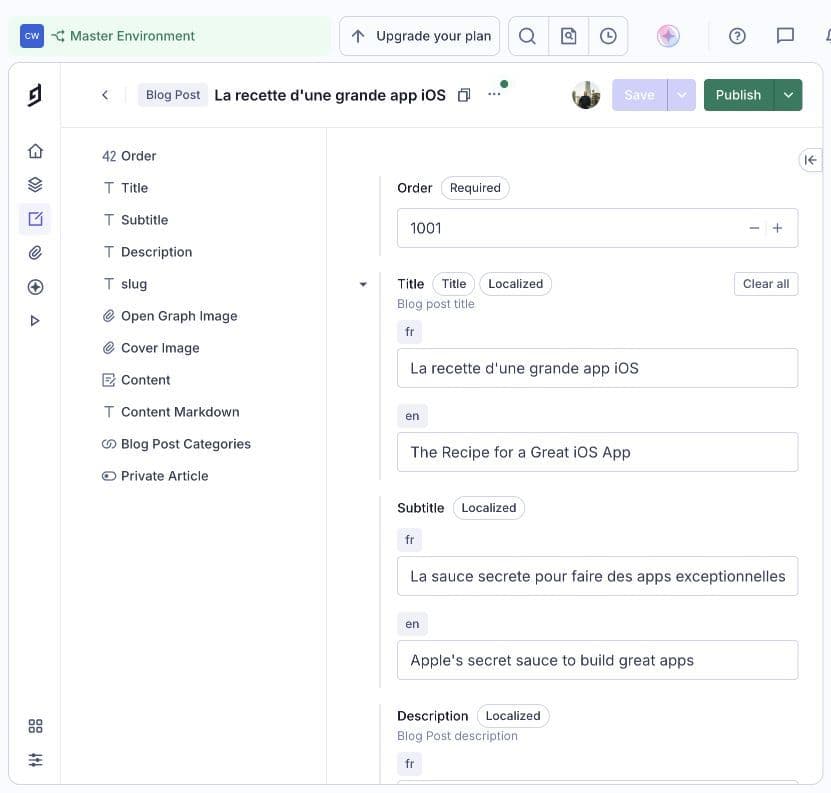
Mein früherer Hygraph-Editor: die französischen und englischen Titel und Untertitel von „Das Rezept für eine großartige iOS-App“ in einem Eintrag. Aufnahme aus meinem Projekt, Oktober 2026.
Auslöser Nr. 1: die Kosten — vor allem die Kosten für Sprachen
Sieben Sprachen in einem Preismodell, das für zwei oder drei gedacht ist
Das hat alles ins Rollen gebracht. Ich veröffentliche mindestens auf Französisch und Englisch, und mein Frontend unterstützt sieben Sprachen. Bei Hygraph ist Lokalisierung eine gestaffelt berechnete Ressource:
- Der kostenlose Hobby-Tarif umfasst 2 Sprachen.
- Growth beginnt bei 199 US-Dollar pro Monat und umfasst 3 Sprachen.
- Darüber landet man bei Zusatzoptionen und Enterprise mit individuellem Angebot (bis zu 80 Sprachen).
Für unabhängige Kreative und kleine Unternehmen, die in mehreren Sprachen erreichbar sein wollen, ist das eine hohe Hürde. Mehrsprachigkeit ist kein Luxus für einen Großkonzern: Sie gehört zum Alltag europäischer Unternehmen. Sie als Premiumoption abzurechnen, empfinde ich als Widerspruch.
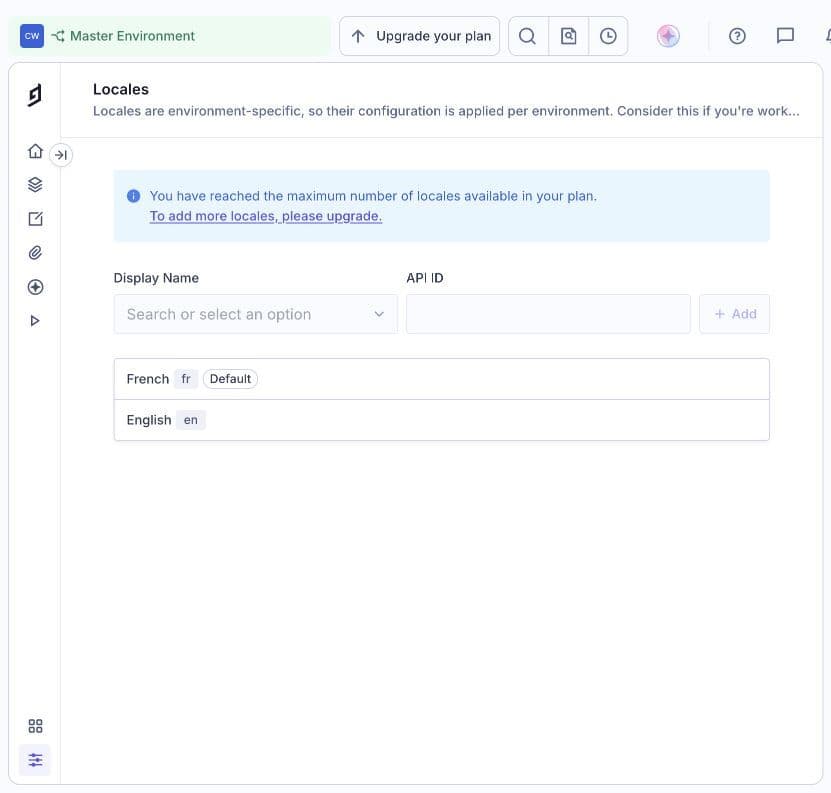
Die Sprachversionen meines Hygraph-Projekts: Französisch als Standardsprache, Englisch und mit diesen beiden Sprachen bereits die Grenze des Tarifs erreicht. Aufnahme aus meinem Projekt, Oktober 2026.
Der Sprung zum Pro-Tarif
Der nächste Schritt: vom kostenlosen zum bezahlten Tarif. Hobby ist in manchen Punkten großzügig, bietet aber nur eine Umgebung. Wer ein echtes Staging braucht, um eine Schemaänderung zu testen, ohne die Produktion zu gefährden, muss auf den nächsten Tarif wechseln. Für etwas so Grundlegendes wie eine Vorproduktionsumgebung auf einmal von 0 auf 199 US-Dollar pro Monat zu springen, ergibt für eine persönliche Website und zwei Community-Projekte kein gutes Preis-Leistungs-Verhältnis.
API-Kontingente und Asset-Traffic
Ein dritter, weniger offensichtlicher Reibungspunkt sind die Kontingente:
- 500.000 API-Aufrufe pro Monat bei Hobby, 1 Million bei Growth. Das klingt nach viel — bis man mehrere Sprachen, generierte Seiten, regelmäßig neu erstellte Podcast-RSS-Feeds und Preview-Builds zusammenzählt.
- 100 GB Asset-Traffic bei Hobby. Podcast-Cover, Artikelbilder und Visuals für ⌘+F summieren sich.
Für sich genommen ist keine dieser Grenzen absurd. Zusammen mit drei Websites, für die ich eigentlich drei Hygraph-Projekte gebraucht hätte, ergibt sich eine Rechnung, die schneller wächst als die Reichweite.
Was Sanity hier verändert
Bei Sanity sieht die Rechnung anders aus:
- Preis — Hygraph Hobby: 0 US-Dollar; Sanity Free: 0 US-Dollar.
- Sprachen — Hygraph Hobby: 2; Sanity Free: unbegrenzt viele*.
- Sitze — Hygraph Hobby: 3; Sanity Free: 20.
- Umgebungen / Datensätze — Hygraph Hobby: 1; Sanity Free: 2 (Produktion + Staging).
- API-Abfragen — Hygraph Hobby: 500.000 Aufrufe pro Monat; Sanity Free: 1 Million CDN-Abfragen + 250.000 API-Abfragen pro Monat.
- Assets — Hygraph Hobby: 100 GB Traffic; Sanity Free: 100 GB Speicher + 100 GB Bandbreite.
* Sanity zählt nicht Sprachen, sondern „unique attributes“ pro Dataset (2.000 im Free-, 10.000 im Growth-Tarif). Bei einer Lokalisierung auf Feldebene vervielfacht jede Sprache die Attributpfade. Das ist die Grenze, die man im Blick behalten muss. Dazu später mehr.
Die Preise stammen von Ende September 2026 und den offiziellen Hygraph- und Sanity-Seiten. Sie ändern sich regelmäßig — bitte vor einer Entscheidung noch einmal prüfen.
Wenn Free nicht mehr reicht, kostet Sanitys Growth-Tarif 15 US-Dollar pro Sitz und Monat. Für ein Team mit zwei oder drei Personen ist das weit entfernt von Hygraph Growth ab 199 US-Dollar — und das mit allen Sprachen.
Auslöser Nr. 2: KI — oder ein CMS als Werkzeug für Agenten
Die Kosten brachten mich dazu, mich umzusehen. Die KI ließ mich Sanity wählen.
Meine Arbeitsweise beim Schreiben hat sich verändert. Ich verfasse, übersetze, lektoriere und veröffentliche immer häufiger mit Agenten — Claude, Codex —, die an meinem Code und meinen Inhalten arbeiten. Die Frage lautet nicht mehr: „Ist die Bearbeitungsoberfläche hübsch?“, sondern: Kann mein Agent meine Inhalte genauso gut verstehen und bearbeiten wie ich?
In dieser Hinsicht hat Sanity einen Vorsprung.
Der MCP-Server: Inhalte aus Claude oder Codex im CMS bearbeiten
Sanity bietet einen offiziellen MCP-Server unter https://mcp.sanity.io. Zum Verbinden genügt ein Befehl:
npx sanity@latest mcp configureEr erkennt den Editor (Claude Code, Cursor, VS Code) und richtet die Verbindung mit den Zugangsdaten der CLI ein. Für Claude Code kann man den Server auch manuell hinzufügen:
claude mcp add Sanity -t http https://mcp.sanity.io --scope userDanach kann der Agent Inhalte mit GROQ abfragen, wenn er das Schema kennt, Dokumente erstellen, patchen, veröffentlichen und zurückziehen, Releases verwalten, Assets über eine URL hochladen und das Schema bereitstellen.
Mein Arbeitsablauf sieht jetzt so aus: Ich erarbeite einen Artikel mit dem Agenten, lese ihn gegen, und der Agent legt den Entwurf direkt in Sanity an — mit den richtigen Feldern, Tags und Übersetzungen. Im Studio prüfe ich alles und veröffentliche. Kein Kopieren und Einfügen mehr zwischen einem Markdown-Editor und einer Weboberfläche.
Übersetzungen in sieben Sprachen
Bei sieben Sprachversionen ist Übersetzen kein Nebenschauplatz, sondern die Hälfte der redaktionellen Arbeit. Mit MCP und Sanitys eingebauten KI-Funktionen (AI Assist, Agent Actions) kann ich für jede Sprache einen ersten Entwurf erstellen und anschließend prüfen lassen. Die KI übernimmt den Großteil der Arbeit; das letzte Wort bleibt beim Menschen, besonders bei Ton und Fachbegriffen.
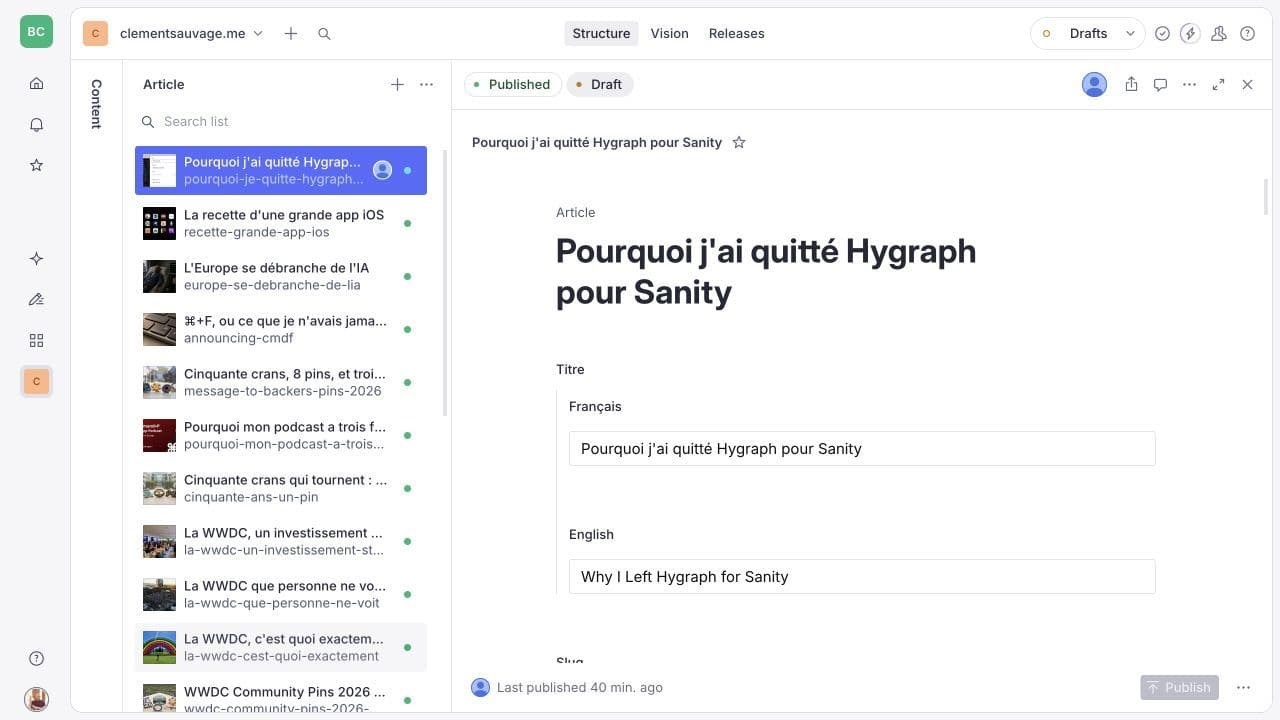
Mein Sanity Studio: die Artikelliste von clementsauvage.me und französische sowie englische Titel in einem Dokument. Aufnahme aus meinem Projekt, Oktober 2026.
Schemata, die KI lesen kann
Das ist das am meisten unterschätzte Argument. Bei Sanity ist das Inhaltsmodell TypeScript-Code und im Repository versioniert. Wenn ein Agent mein Projekt öffnet, sieht er gleichzeitig das Next.js-Frontend, die Abfragen und die genaue Definition jedes Dokumenttyps. Er muss das Modell nicht erst in einer Weboberfläche „entdecken“: Er liest es wie den übrigen Code.
Für jemanden, der No-Code-Oberflächen mag, ist das ein Nachteil (dazu später mehr). Für einen Agenten ist es ein entscheidender Vorteil: Der gesamte Kontext liegt am selben Ort.
Was sich technisch durch die Migration verändert hat
Lokalisierung auf Feldebene
Ich habe mich für Lokalisierung auf Feldebene entschieden: ein Dokument pro Artikel, dessen Felder jeweils einen Wert pro Sprache enthalten. Das offizielle Plugin sanity-plugin-internationalized-array übernimmt die Arbeit.
Die Konfiguration bindet das Plugin sanity-plugin-internationalized-array ein und übergibt ihm die Sprachliste aus i18n/locales — dieselbe Quelle wie next-intl. Die Sprach-IDs werden als Titel in Großbuchstaben angezeigt; die Feldtypen string und text werden lokalisiert. Im Schema erhalten title und excerpt die Typen internationalizedArrayString und internationalizedArrayText. Der Slug wird aus dem französischen Titel abgeleitet; Veröffentlichungsdatum und Titelbild bleiben gemeinsam.
// sanity.config.ts
import { defineConfig } from 'sanity'
import { internationalizedArray } from 'sanity-plugin-internationalized-array'
import { LOCALES } from './i18n/locales' // dieselbe Quelle wie next-intl

export default defineConfig({
  // ...
  plugins: [
    internationalizedArray({
      languages: LOCALES.map((id) => ({ id, title: id.toUpperCase() })),
      fieldTypes: ['string', 'text'],
    }),
  ],
})

// schemas/post.ts
import { defineType, defineField } from 'sanity'

export const post = defineType({
  name: 'post',
  title: 'Artikel',
  type: 'document',
  fields: [
    defineField({ name: 'title', type: 'internationalizedArrayString' }),
    defineField({ name: 'excerpt', type: 'internationalizedArrayText' }),
    defineField({
      name: 'slug',
      type: 'slug',
      options: { source: (doc: any) => doc.title?.find((t: any) => t.language === 'fr')?.value },
    }),
    defineField({ name: 'publishedAt', type: 'datetime' }),
    defineField({ name: 'cover', type: 'image', options: { hotspot: true } }),
  ],
})
Warum Feldebene statt eines Dokuments pro Sprache? Meine Artikel teilen die meisten Angaben — Datum, Bilder, Tags, Autoren —, nur die Texte unterscheiden sich. Ein Dokument bedeutet eine einzige verlässliche Quelle. Ein Agent, der übersetzt, muss nur ein Objekt patchen.
Ein Detail, das einen Abend kosten kann: Seit Version 5 des Plugins wird die Sprache in einem Feld namens language und nicht mehr in _key gespeichert. Alte Beispiele im Netz mit _key == "fr" funktionieren nicht mehr.
Von Apollo und GraphQL zu GROQ
Das war der größte Umbau im Frontend. Ich habe Apollo Client zugunsten von next-sanity, GROQ und TypeGen aufgegeben.
Der Vergleich zeigt den Wechsel von Apollo und GraphQL zu next-sanity und GROQ:
// Vorher — Apollo + Hygraph GraphQL
const GET_POSTS = gql`
  query Posts($locale: Locale!) {
    posts(locales: [$locale, fr], orderBy: publishedAt_DESC, first: 10) {
      title
      slug
      excerpt
      coverImage { url }
    }
  }
`
const { data } = await client.query({ query: GET_POSTS, variables: { locale } })

// Danach — next-sanity + GROQ
import { defineQuery } from 'next-sanity'

export const POSTS_QUERY = defineQuery(`
  *[_type == "post" && defined(slug.current)] | order(publishedAt desc)[0...10]{
    "title": coalesce(title[language == $locale][0].value, title[language == "fr"][0].value),
    "excerpt": coalesce(excerpt[language == $locale][0].value, excerpt[language == "fr"][0].value),
    "slug": slug.current,
    "cover": cover.asset->url
  }
`)

const posts = await client.fetch(POSTS_QUERY, { locale })
Anschließend:
npx sanity typegen generateTypeGen erzeugt TypeScript-Typen aus dem Schema und den Abfragen. Das Ergebnis der Posts-Abfrage ist durchgehend typisiert, ohne dass ich ein einziges Interface von Hand schreiben muss.
Was ich gewonnen habe: weniger Abhängigkeiten (kein Apollo mehr, kein clientseitiger Cache, den ich konfigurieren müsste), einen direkt in der Abfrage definierten Sprach-Fallback mit coalesce und Projektionen, die genau die Form zurückgeben, die die Komponente braucht.
Was ich Hygraph zugutehalte
Es wäre unehrlich, hier aufzuhören. Hygraph hat echte Stärken, und einige davon fehlen mir.
- GraphQL von Haus aus. Ein Standard, den das ganze Team kennt, mit ausgereiftem Werkzeug-Ökosystem. Man ist nicht an eine eigene Abfragesprache gebunden.
- Native Lokalisierung. Bei Hygraph sind Sprachen ein Feature erster Klasse: Sprache auswählen, und jedes Feld lässt sich lokalisieren. Kein Plugin, keine Konfiguration. Einfacher — nur eben teuer.
- No-Code-Schema-Builder. Jemand ohne technischen Hintergrund kann das Inhaltsmodell eigenständig über die Oberfläche erweitern. Bei Sanity geht das nicht ohne Codeänderung.
- Content Federation. Externe APIs anzuschließen und alles hinter einem einzigen GraphQL-Endpunkt anzubieten, ist sehr leistungsfähig für Unternehmen mit verstreuten Datenquellen. Ich brauchte es nicht, aber es ist ein echtes Unterscheidungsmerkmal.
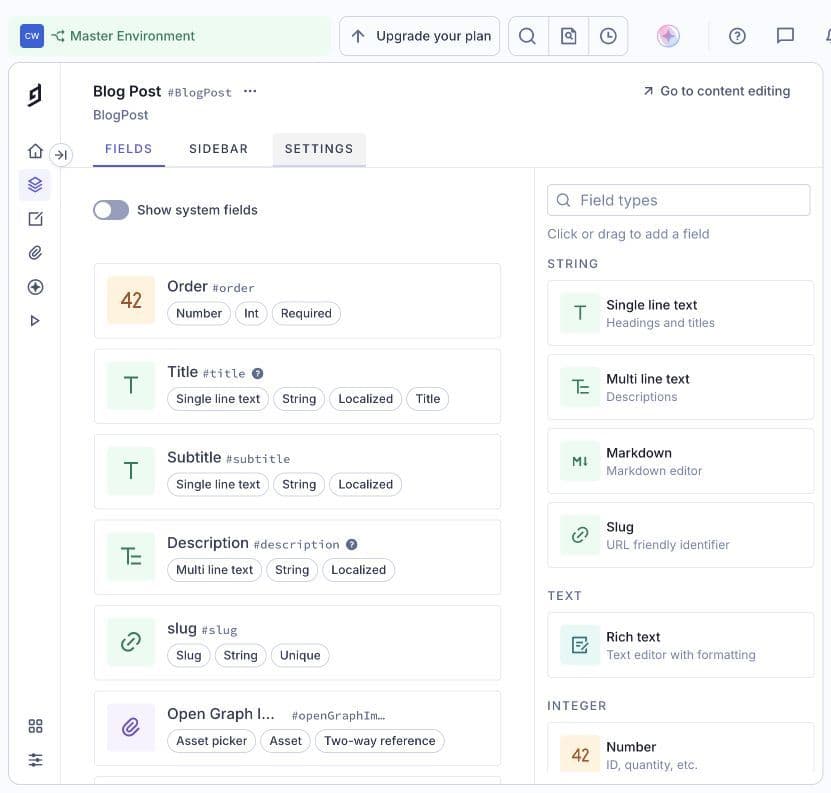
Das Blog-Post-Modell meines Hygraph-Projekts: lokalisierte Felder und verfügbare Feldtypen im Schema-Builder. Aufnahme aus meinem Projekt, Oktober 2026.
Wenn du in einem mittelgroßen Marketingteam arbeitest, nur wenige Sprachen brauchst, nichttechnischen Redakteuren Eigenständigkeit beim Modell geben möchtest und ein Budget für das CMS hast, ist Hygraph weiterhin eine sehr gute Wahl.
Meine Kritik bezieht sich auf einen konkreten Punkt: Das Preismodell benachteiligt kleine mehrsprachige Anbieter. Das ist eine legitime Geschäftsentscheidung, aber dadurch gehöre ich nicht mehr zur Zielgruppe.
Was Sanity nicht besser macht
Dieselbe Ehrlichkeit gilt in die andere Richtung.
GROQ muss man lernen. Es ist eine proprietäre Sprache. Nach der Einarbeitung ist sie leistungsfähig, knapp und angenehm — aber sie bindet meine Abfragen an ein CMS. Ich habe eine Preisabhängigkeit gegen eine Syntaxabhängigkeit eingetauscht, und zwar bewusst. (Sanity bietet auch eine GraphQL-API an, aber dann verliert man einen großen Teil des Vorteils.)
Alles läuft über Entwickler. Ein Schema als Code ist für Entwickler und Agenten großartig. Für einen nichttechnischen Redakteur, der ein Feld ergänzen will, ist die Tür zu. In meinem Fall bin ich selbst der Entwickler, also ist das kein Problem. In einem Team kann es eines sein.
Internationalisierung ist weniger nativ. Man muss eine Strategie wählen (Feld oder Dokument), ein Plugin installieren, Versionsmigrationen berücksichtigen (das erwähnte _key → language) und die Grenze für eindeutige Dataset-Attribute beobachten. Bei sieben Sprachen auf Feldebene kann sie schnell erreicht sein. Nichts davon ist unüberwindbar, aber Hygraph nimmt einem diese Arbeit ab.
Jenseits des CMS: 2026 ein SaaS-Werkzeug auswählen — und wieder verlassen
Diese Migration hat mich vor allem an eines erinnert: Ein Werkzeug ist keine endgültige Entscheidung, sondern eine Entscheidung für einen bestimmten Zeitpunkt. Hygraph war die richtige Wahl, als ich meinen Stack gestartet habe. Mit meinen veränderten Anforderungen war es das nicht mehr.
Drei Erkenntnisse, die ich mitnehme und auch Kunden weitergebe:
1. Berechne die Kosten entlang deiner Entwicklung, nicht nur für den heutigen Stand. Preismodelle sind so gebaut, dass der Einstieg schmerzlos wirkt. Frag dich: Was kostet es mit doppelt so vielen Sprachen, Inhalten, Websites oder Mitwirkenden? Dort werden die Unterschiede sichtbar.
2. 2026 sollte „Kann der Agent damit arbeiten?“ ein zentrales Kriterium sein. Ein Werkzeug mit offiziellem MCP-Server, einem im Code lesbaren Modell und einer skriptbaren API spart dir jede Woche Stunden. Ein Werkzeug, das sich nur mit der Maus bedienen lässt, wird zum Engpass.
3. Halte deine Inhalte portabel. Ich konnte migrieren, weil meine Inhalte strukturiert waren und ich das Frontend kontrollierte. Wenn du das Werkzeug wechselst, entscheidet die Qualität deines Inhaltsmodells darüber, ob die Migration eine Woche oder drei Monate dauert.
Checkliste für die Wahl eines Headless-CMS
Diese Fragen stelle ich mir jetzt — für mich und für meine Kunden:
Inhalte und Sprachen
- ☐ Wie viele Sprachen brauchst du heute? Und in zwei Jahren?
- ☐ Ist Lokalisierung inklusive, begrenzt oder wird pro Sprache abgerechnet?
- ☐ Erfolgt sie auf Feld-, Dokument- oder beiden Ebenen?
Kosten
- ☐ Was kostet die nächste Tarifstufe und wodurch wird sie ausgelöst (Sitze, Sprachen, Umgebungen, Kontingente)?
- ☐ Wie werden API-Aufrufe gezählt und was passiert bei Überschreitung?
- ☐ Ist eine Staging-Umgebung schon im kostenlosen Tarif enthalten?
Team
- ☐ Wer entwickelt das Inhaltsmodell weiter: ein Entwickler oder ein Redakteur?
- ☐ Brauchst du Zusammenarbeit in Echtzeit?
Entwicklung
- ☐ Liegt das Schema versioniert mit dem Frontend im Code?
- ☐ Standard-Abfragesprache (GraphQL) oder proprietäre Sprache (GROQ …): bist du bereit, sie zu lernen?
- ☐ Werden Typen automatisch generiert?
KI und Agenten
- ☐ Gibt es einen offiziellen MCP-Server?
- ☐ Kann ein Agent das Schema lesen sowie Inhalte erstellen, ändern und veröffentlichen?
- ☐ Gibt es integrierte Übersetzungs- oder Generierungswerkzeuge, und was kosten sie?
Ausstieg
- ☐ Kannst du alle Inhalte in einem offenen Format exportieren?
- ☐ Was würde eine Migration in zwei Jahren kosten?
Wenn du diese Fragen vorher beantwortest, vermeidest du die meisten Überraschungen. Wenn du sie nachher beantwortest — so wie ich —, weißt du wenigstens, wann es Zeit ist zu gehen.
Wie es weitergeht
Mein ganzes Ökosystem lebt jetzt in einem einzigen Sanity-Projekt: die Artikel dieses Blogs, die Inhalte von ⌘+F und die Folgen von ⌘+P. Ein Modell, sieben Sprachen und Agenten, die direkt im CMS arbeiten.
Heute empfehle ich auch meinen Kunden eine Migration zu Sanity. Drei von ihnen haben den Schritt bereits gemacht. Die Migration der Inhaltsmodelle und mehrerer Tausend Seiten dauerte nur einige Stunden — bei den größten Projekten etwa zehn. Manche haben ihre Migrationskosten innerhalb von drei Monaten wieder hereingeholt.
Wenn du bei deinem Content-Stack unsicher bist, eine Migration planst oder deine KI-Agenten an dein CMS anschließen willst, ist das genau die Art von Thema, bei der ich mit BNC Consulting unterstütze. Schreib mir.
Und wenn du dich mit anderen Entwicklern austauschen willst, komm zur ⌘+F-Community. Solche Erfahrungen teilen wir auch bei Meetups, auf einen Kaffee oder beim Abendessen.
— Clément