Blog, ⌘+F et podcast ⌘+P : j'ai migré tous mes contenus de Hygraph vers Sanity. Ce qui a déclenché la décision, ce que je concède à Hygraph, ce que Sanity ne fait pas mieux, et la grille que j'utilise désormais pour choisir un CMS.
Il y a des migrations qu'on repousse parce que tout marche. Mon site tournait. Les articles sortaient en plusieurs langues, le podcast ⌘+P avait ses flux RSS, ⌘+F avait sa vitrine. Hygraph faisait le travail.
Et pourtant, c'est fait : clementsauvage.me, cmdf.io et le podcast ⌘+P tournent désormais sur Sanity, en production. Un seul projet, un seul modèle de contenu, sept locales.
Cet article n'est pas un « Hygraph c'est nul, Sanity c'est génial ». Hygraph m'a bien servi, et il reste un excellent choix pour certains profils. C'est le récit d'un changement de besoins, avec deux déclencheurs très concrets — le coût et l'IA — et une réflexion plus large sur la façon dont un entrepreneur devrait choisir (et quitter) un outil SaaS en 2026.
Le point de départ : une stack qui marchait
Pour situer, voici la stack d'avant :
- Hygraph comme CMS headless, en GraphQL natif
- Next.js 16 (App Router, Turbopack), Tailwind v4
- Apollo Client pour parler à l'API GraphQL
- next-intl pour gérer sept locales
- Clever Cloud Cellar (S3) derrière Cloudflare pour une partie des fichiers, Mux pour la vidéo
Rien d'exotique. Une stack moderne, propre, que je recommandais encore à des clients il y a quelques mois.
Le problème n'est pas venu d'un bug. Il est venu d'une trajectoire : plus de langues, plus de contenus, plus de sites, et une façon de travailler qui a basculé vers les agents IA. Et à chaque étape, Hygraph me coûtait un peu plus cher — en argent ou en friction.
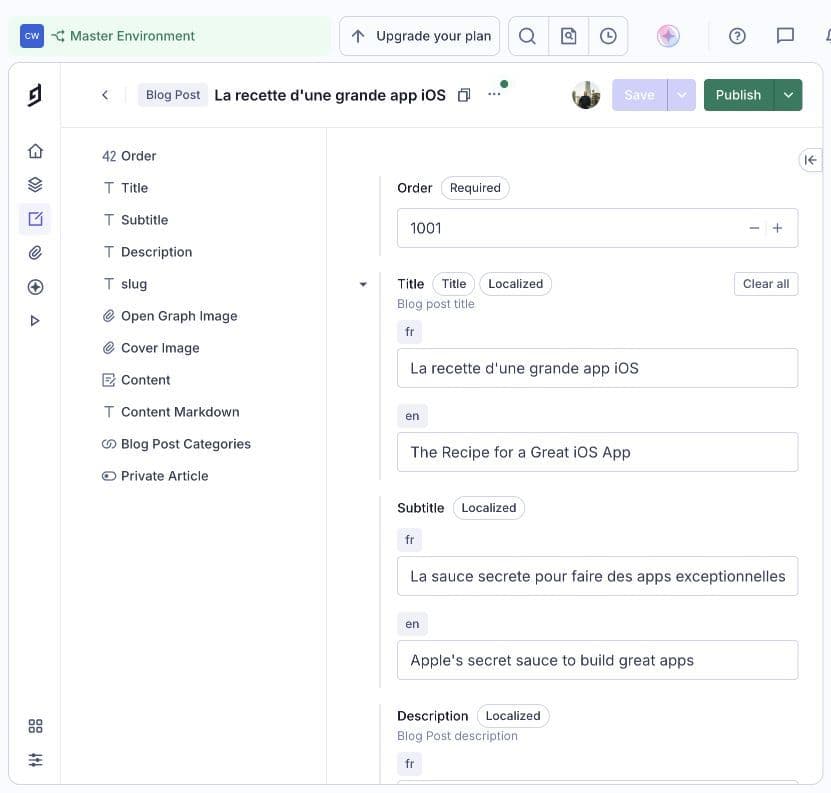
Mon ancien éditeur Hygraph : les titres et sous-titres français et anglais de « La recette d’une grande app iOS », dans une même entrée. Capture de mon projet, octobre 2026.
Déclencheur n° 1 : le coût, et surtout le coût des langues
Sept locales, dans une grille tarifaire pensée pour deux ou trois
C'est le point qui a tout déclenché. Je publie en français et en anglais au minimum, et mon front gère sept locales. Or, chez Hygraph, la localisation est une ressource facturée au palier :
- le plan Hobby (gratuit) inclut 2 locales ;
- le plan Growth démarre à partir de 199 $/mois et inclut 3 locales ;
- au-delà, on entre dans le territoire des options et de l'Enterprise, sur devis (jusqu'à 80 locales).
Pour un créateur indépendant ou une petite structure qui veut être lisible dans plusieurs langues, c'est un mur. Le multilinguisme n'est pas un luxe d'entreprise du CAC 40 : c'est le quotidien de n'importe quel acteur européen. Qu'il soit facturé comme une option premium, je le vis comme un contresens.
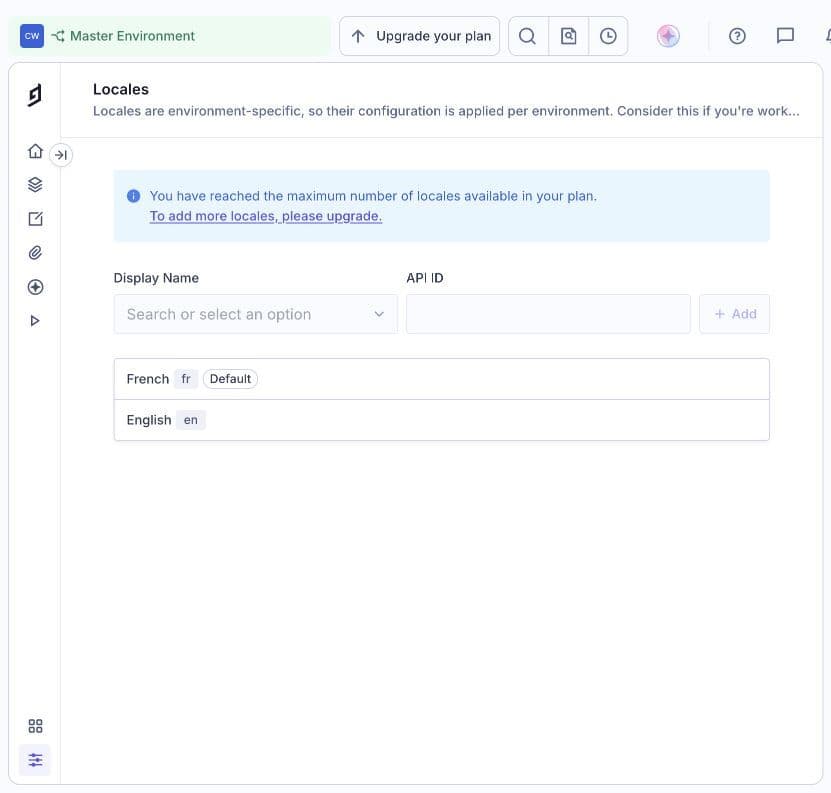
Les locales de mon projet Hygraph : français par défaut, anglais, et la limite de l’offre atteinte avec ces deux langues. Capture de mon projet, octobre 2026.
Le saut du palier Pro
Deuxième marche : le passage du gratuit au payant. Le Hobby est généreux sur certains points, mais il n'offre qu'un seul environnement. Dès qu'on veut un vrai staging pour tester une évolution de schéma sans casser la production, il faut passer au palier supérieur. De 0 à 199 $/mois d'un coup, pour un besoin aussi basique qu'un environnement de préproduction, le ratio valeur/prix ne tient plus pour un site personnel et deux projets communautaires.
Les quotas d'API et le trafic d'assets
Troisième frottement, plus sournois : les quotas.
- 500 000 opérations API/mois sur le Hobby, 1 million sur le Growth. Ça paraît beaucoup, jusqu'à ce qu'on multiplie les locales, les pages générées, les flux RSS du podcast régénérés régulièrement et les builds de prévisualisation.
- 100 Go de trafic d'assets sur le Hobby. Les covers du podcast, les visuels d'articles et d'événements ⌘+F finissent par peser.
Pris isolément, aucun de ces plafonds n'est scandaleux. Ensemble, avec trois sites qui auraient dû être trois projets Hygraph, ils dessinent une facture qui grossit plus vite que l'audience.
Ce que Sanity change sur ce plan
Côté Sanity, la logique est différente :
- Prix — Hygraph Hobby : 0 $ ; Sanity Free : 0 $.
- Locales — Hygraph Hobby : 2 ; Sanity Free : Non limitées en nombre*.
- Sièges — Hygraph Hobby : 3 ; Sanity Free : 20.
- Environnements / datasets — Hygraph Hobby : 1 ; Sanity Free : 2 (production + staging).
- Requêtes API — Hygraph Hobby : 500 k ops/mois ; Sanity Free : 1 M requêtes CDN + 250 k requêtes API/mois.
- Assets — Hygraph Hobby : 100 Go de trafic ; Sanity Free : 100 Go de stockage + 100 Go de bande passante.
* Sanity ne compte pas les langues, mais les « attributs uniques » par dataset (2 000 en Free, 10 000 en Growth). Avec une localisation au niveau des champs, chaque langue multiplie les chemins d'attributs : c'est la limite à surveiller. J'y reviens plus bas.
Tarifs relevés fin septembre 2026 sur les pages officielles de Hygraph et Sanity. Ils bougent souvent : vérifiez avant de décider.
Et quand le Free ne suffit plus, le palier Growth de Sanity est à 15 $ par siège et par mois. Pour une équipe de deux ou trois personnes, on reste loin des 199 $ d'entrée de Hygraph Growth — avec toutes les langues.
Déclencheur n° 2 : l'IA, ou le CMS comme outil d'agent
Le coût m'a fait regarder ailleurs. L'IA m'a fait choisir Sanity.
Ma façon d'écrire a changé. Je rédige, je traduis, je relis et je publie de plus en plus avec des agents — Claude, Codex — qui travaillent sur mon code et mes contenus. La question n'est plus « est-ce que l'interface d'édition est jolie ? », mais : est-ce que mon agent peut comprendre et manipuler mon contenu aussi bien que moi ?
Sur ce terrain, Sanity a pris une longueur d'avance.
Le serveur MCP : écrire dans le CMS depuis Claude ou Codex
Sanity propose un serveur MCP officiel, hébergé sur https://mcp.sanity.io. Une commande suffit pour le brancher :
npx sanity@latest mcp configure
Elle détecte l'éditeur (Claude Code, Cursor, VS Code) et configure la connexion avec les identifiants de la CLI. Pour Claude Code, on peut aussi l'ajouter à la main :
claude mcp add Sanity -t http https://mcp.sanity.io --scope user
À partir de là, l'agent peut interroger le contenu en GROQ en connaissant le schéma, créer, patcher, publier et dépublier des documents, gérer des releases, uploader des assets depuis une URL et déployer le schéma.
Concrètement, mon flux ressemble maintenant à ça : je travaille un article avec l'agent, je relis, et l'agent crée le brouillon directement dans Sanity, avec les bons champs, les bons tags et les traductions. Je relis dans le Studio et je publie. Plus de copier-coller entre un éditeur Markdown et une interface web.
La traduction dans sept langues
Avec sept locales, la traduction n'est pas un détail : c'est la moitié du travail éditorial. Entre le MCP et les fonctions IA intégrées de Sanity (AI Assist, Agent Actions), je peux générer une première version de chaque langue, puis la faire relire. L'IA fait le gros œuvre ; l'humain garde le dernier mot, en particulier sur le ton et les termes techniques.
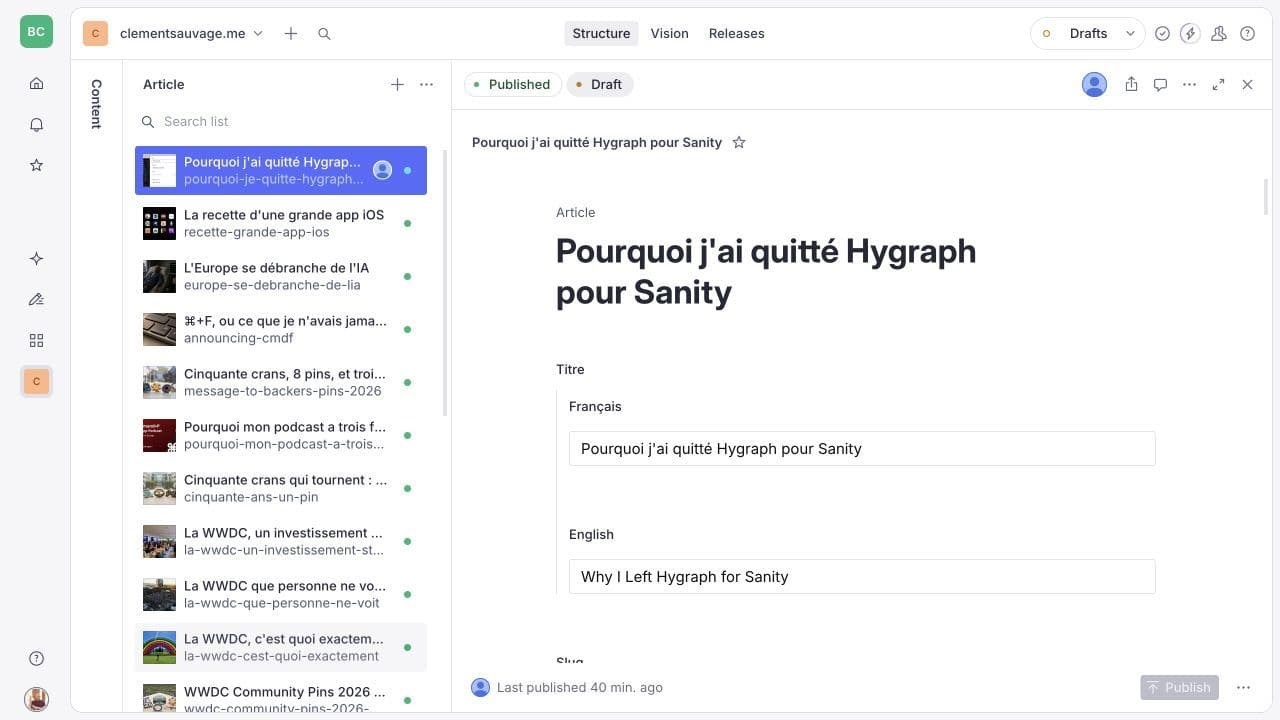
Mon Sanity Studio : la liste des articles de clementsauvage.me et les titres français et anglais réunis dans un même document. Capture de mon projet, octobre 2026.
Des schémas que l'IA sait lire
C'est l'argument le plus sous-estimé. Chez Sanity, le modèle de contenu est du code TypeScript, versionné dans le repo. Quand un agent ouvre mon projet, il voit en même temps le front Next.js, les requêtes et la définition exacte de chaque type de document. Il n'a pas besoin d'aller « découvrir » le modèle dans une interface web : il le lit, comme il lit le reste du code.
Pour un humain qui aime les interfaces no-code, c'est un inconvénient (j'y reviens). Pour un agent, c'est un avantage décisif : tout le contexte est au même endroit.
Ce que la migration a changé techniquement
La localisation au niveau des champs
J'ai choisi une localisation field-level : un seul document par article, et des champs qui contiennent une valeur par langue. Le plugin officiel sanity-plugin-internationalized-array fait le travail :
// sanity.config.ts
import { defineConfig } from 'sanity'
import { internationalizedArray } from 'sanity-plugin-internationalized-array'
import { LOCALES } from './i18n/locales' // la même source que next-intl

export default defineConfig({
  // ...
  plugins: [
    internationalizedArray({
      languages: LOCALES.map((id) => ({ id, title: id.toUpperCase() })),
      fieldTypes: ['string', 'text'],
    }),
  ],
})
// schemas/post.ts
import { defineType, defineField } from 'sanity'

export const post = defineType({
  name: 'post',
  title: 'Article',
  type: 'document',
  fields: [
    defineField({ name: 'title', type: 'internationalizedArrayString' }),
    defineField({ name: 'excerpt', type: 'internationalizedArrayText' }),
    defineField({
      name: 'slug',
      type: 'slug',
      options: { source: (doc: any) => doc.title?.find((t: any) => t.language === 'fr')?.value },
    }),
    defineField({ name: 'publishedAt', type: 'datetime' }),
    defineField({ name: 'cover', type: 'image', options: { hotspot: true } }),
  ],
})
Pourquoi le field-level plutôt qu'un document par langue ? Parce que mes articles partagent l'essentiel — date, visuels, tags, auteurs — et que seuls les textes changent. Un seul document, c'est une seule source de vérité, et un agent qui traduit n'a qu'un objet à patcher.
Un détail qui peut coûter une soirée : depuis la version 5 du plugin, la langue est stockée dans un champ language, et non plus dans _key. Les anciens exemples en _key == "fr" qui traînent sur le web ne fonctionnent plus.
D'Apollo et GraphQL à GROQ
C'est le plus gros chantier côté front. J'ai abandonné Apollo Client au profit de next-sanity, de GROQ et de TypeGen.
Avant, avec Hygraph :
// Avant — Apollo + GraphQL Hygraph
const GET_POSTS = gql`
  query Posts($locale: Locale!) {
    posts(locales: [$locale, fr], orderBy: publishedAt_DESC, first: 10) {
      title
      slug
      excerpt
      coverImage { url }
    }
  }
`
const { data } = await client.query({ query: GET_POSTS, variables: { locale } })
Après, avec Sanity :
// Après — next-sanity + GROQ
import { defineQuery } from 'next-sanity'

export const POSTS_QUERY = defineQuery(`
  *[_type == "post" && defined(slug.current)] | order(publishedAt desc)[0...10]{
    "title": coalesce(title[language == $locale][0].value, title[language == "fr"][0].value),
    "excerpt": coalesce(excerpt[language == $locale][0].value, excerpt[language == "fr"][0].value),
    "slug": slug.current,
    "cover": cover.asset->url
  }
`)

const posts = await client.fetch(POSTS_QUERY, { locale })
Puis :
npx sanity typegen generate
TypeGen génère les types TypeScript à partir du schéma et des requêtes. Le résultat de POSTS_QUERY est typé de bout en bout, sans écrire une seule interface à la main.
Ce que j'ai gagné : moins de dépendances (plus d'Apollo, plus de cache client à configurer), un fallback de langue écrit directement dans la requête avec coalesce, et des projections qui renvoient exactement la forme dont le composant a besoin.
Ce que je concède à Hygraph
Il serait malhonnête de s'arrêter là. Hygraph a de vrais atouts, et certains me manquent.
- GraphQL natif. C'est un standard. Toute l'équipe le connaît, l'outillage est mûr, et on n'est pas enfermé dans un langage maison.
- La localisation native. Chez Hygraph, les locales sont une fonctionnalité de premier niveau : on coche une langue, et chaque champ devient localisable. Pas de plugin, pas de configuration. C'est plus simple — c'est simplement facturé cher.
- Le schema builder no-code. Un profil non technique peut faire évoluer le modèle de contenu seul, depuis l'interface. Chez Sanity, c'est impossible sans passer par le code.
- La fédération de contenu. Brancher des API externes et tout exposer derrière un seul endpoint GraphQL, c'est très puissant pour une entreprise qui a des données éparpillées. Je n'en avais pas l'usage, mais c'est un vrai différenciant.
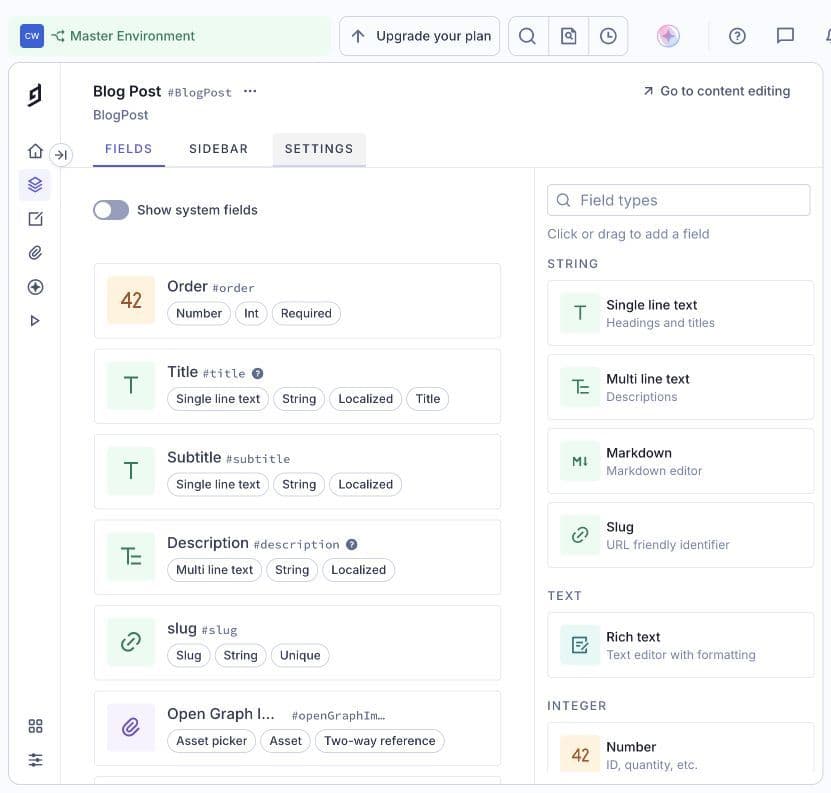
Le modèle Blog Post de mon projet Hygraph : champs localisés et types de champs disponibles dans le schema builder. Capture de mon projet, octobre 2026.
Si vous êtes une équipe marketing de taille moyenne, avec peu de langues, des éditeurs non techniques qui veulent de l'autonomie sur le modèle, et un budget prévu pour le CMS, Hygraph reste un très bon choix.
Mon reproche porte sur un point précis : son modèle tarifaire pénalise les petits acteurs multilingues. C'est un choix commercial légitime, mais il m'a exclu de la cible.
Ce que Sanity ne fait pas mieux
Même honnêteté dans l'autre sens.
GROQ, il faut l'apprendre. C'est un langage propriétaire. Il est puissant, concis et agréable une fois maîtrisé, mais c'est un lock-in d'un autre genre : mes requêtes ne sont plus portables vers un autre CMS. J'ai échangé une dépendance tarifaire contre une dépendance syntaxique, en connaissance de cause. (Sanity propose aussi une API GraphQL, mais on perd alors une bonne partie de l'intérêt.)
Tout passe par le développeur. Le schéma en code, c'est formidable pour un dev et pour un agent. Pour un éditeur non technique qui veut ajouter un champ, c'est une porte fermée. Dans mon cas, je suis le développeur, donc la question ne se pose pas. Dans une équipe, elle se pose.
L'i18n est moins native. Il faut choisir une stratégie (champ ou document), installer un plugin, gérer les migrations de version (le fameux _key → language), et surveiller la limite d'attributs uniques du dataset, qui grimpe vite en field-level avec sept langues. Rien d'insurmontable, mais c'est du travail que Hygraph fait pour vous.
Au-delà du CMS : comment choisir (et quitter) un outil SaaS en 2026
Cette migration m'a surtout rappelé une chose : un outil n'est pas un choix définitif, c'est un choix à un instant donné. Hygraph était le bon choix quand j'ai lancé la stack. Il ne l'était plus quand mes besoins ont changé.
Trois leçons que je retiens, et que je partage avec les clients que j'accompagne.
1. Modélisez le coût sur votre trajectoire, pas sur votre situation actuelle. Les grilles tarifaires sont conçues pour être indolores au départ. Posez-vous la question : combien ça coûte avec deux fois plus de langues, de contenus, de sites ou de contributeurs ? C'est là que les écarts apparaissent.
2. En 2026, « l'agent peut-il s'en servir ? » est un critère de premier rang. Un outil qui expose un serveur MCP officiel, un modèle lisible en code et une API scriptable vous fera gagner des heures chaque semaine. Un outil qui ne se pilote qu'à la souris va devenir un goulot d'étranglement.
3. Gardez votre contenu portable. J'ai pu migrer parce que mes contenus étaient structurés et que je contrôlais le front. Le jour où vous changez d'outil, c'est la qualité de votre modèle de contenu qui décide si la migration prend une semaine ou trois mois.
Checklist : choisir son CMS headless
La grille que j'utilise désormais, pour moi comme pour mes clients :
Contenu et langues
- ☐ Combien de langues aujourd'hui ? Et dans deux ans ?
- ☐ La localisation est-elle incluse, limitée ou facturée à la langue ?
- ☐ Localisation au niveau du champ, du document, ou les deux ?
Coût
- ☐ Quel est le coût au prochain palier, et qu'est-ce qui le déclenche (sièges, langues, environnements, quotas) ?
- ☐ Comment sont comptés les appels API, et que se passe-t-il en cas de dépassement ?
- ☐ Un environnement de staging est-il inclus dès l'offre gratuite ?
Équipe
- ☐ Qui fait évoluer le modèle de contenu : un dev ou un éditeur ?
- ☐ Faut-il de la collaboration en temps réel ?
Développeur
- ☐ Le schéma vit-il dans le code, versionné avec le front ?
- ☐ Langage de requête standard (GraphQL) ou propriétaire (GROQ…) : êtes-vous prêt à l'apprendre ?
- ☐ Les types sont-ils générés automatiquement ?
IA et agents
- ☐ Existe-t-il un serveur MCP officiel ?
- ☐ Un agent peut-il lire le schéma, créer, modifier et publier du contenu ?
- ☐ Des outils de traduction ou de génération sont-ils intégrés, et à quel coût ?
Sortie
- ☐ Peut-on exporter tout le contenu dans un format ouvert ?
- ☐ Combien coûterait une migration dans deux ans ?
Si vous répondez à ces questions avant de choisir, vous éviterez la plupart des mauvaises surprises. Si vous y répondez après, comme moi, vous saurez au moins quand il est temps de partir.
Et maintenant ?
Tout mon écosystème vit désormais dans un seul projet Sanity : les articles de ce blog, les contenus ⌘+F et les épisodes de ⌘+P. Un modèle unique, sept langues, et des agents qui travaillent directement dans le CMS.
Aujourd'hui, j'invite aussi mes clients à migrer vers Sanity. Trois d'entre eux ont déjà franchi le pas. La migration des modèles de contenu et de plusieurs milliers de pages n'a pris que quelques heures — de l'ordre d'une dizaine d'heures pour les plus gros projets. Certains ont rentabilisé leur migration en trois mois.
Si vous hésitez sur votre stack de contenu, que vous envisagez une migration ou que vous voulez brancher vos agents IA sur votre CMS, c'est exactement le genre de sujet que j'accompagne avec BNC Consulting. Écrivez-moi.
Et si vous voulez en discuter entre développeurs, rejoignez la communauté ⌘+F : ce genre de retour d'expérience, on le partage aussi en meetup, autour d'un café ou d'un dîner.
— Clément